GraphRAG en producción: cuándo usar grafos en RAG y cómo evitar una arquitectura innecesaria
GraphRAG no sustituye por defecto al RAG vectorial: esta guía explica cuándo un grafo aporta valor, cómo diseñarlo con procedencia y permisos, y cómo probarlo antes de asumir su coste operativo.
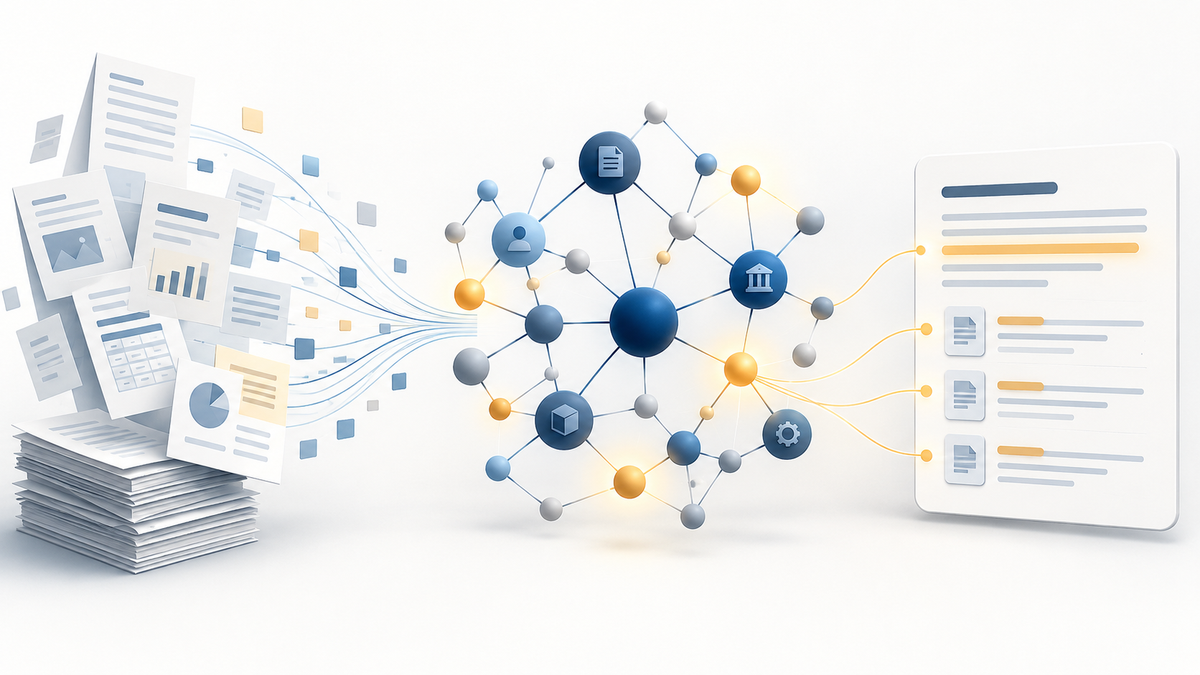
GraphRAG es un patrón de recuperación aumentada en el que un grafo de entidades, relaciones y evidencias complementa —no reemplaza automáticamente— a los índices vectoriales o léxicos. Su ventaja aparece cuando la respuesta depende de conexiones explícitas, varios saltos, comunidades de documentos o una síntesis sobre un corpus completo.
La definición también marca el límite: si la pregunta se responde con un párrafo bien recuperado, un grafo añade ingestión, almacenamiento, actualización y observabilidad sin beneficio. La etiqueta GraphRAG no convierte una extracción dudosa en conocimiento fiable.
Matriz de decisión: vectorial, híbrido o GraphRAG
Usa la siguiente matriz como hipótesis inicial y no como sustituto de una evaluación:
RAG vectorial: elige esta opción cuando las preguntas buscan pasajes similares, el corpus cambia con frecuencia, necesitas una operación sencilla y la trazabilidad por chunk es suficiente. Es el baseline más barato de mantener.
RAG híbrido: combina BM25 o búsqueda léxica con vectores y, si hace falta, reranking. Es preferible cuando hay nombres propios, códigos, números, términos exactos y lenguaje natural mezclados. La [guía de búsqueda híbrida](/busqueda-hibrida-rag-bm25-vectorial-reranking/) ayuda a establecer este baseline antes de añadir estructura.
GraphRAG: pruébalo cuando las consultas exigen relaciones entre entidades, varios saltos, navegación por dependencias, agrupación temática o síntesis global sobre un corpus grande. Exige que las entidades sean relativamente estables y que la procedencia se pueda auditar.
No uses GraphRAG solo porque el equipo ya tenga Neo4j, porque un diagrama se vea bien o porque el LLM pueda generar triples. La pregunta decisiva es: ¿qué consultas fallan en el baseline y qué señal del grafo debería corregirlas? Si no puedes responderla, conserva la arquitectura simple.
Checklist
Pipeline de ingestión: del texto a la evidencia
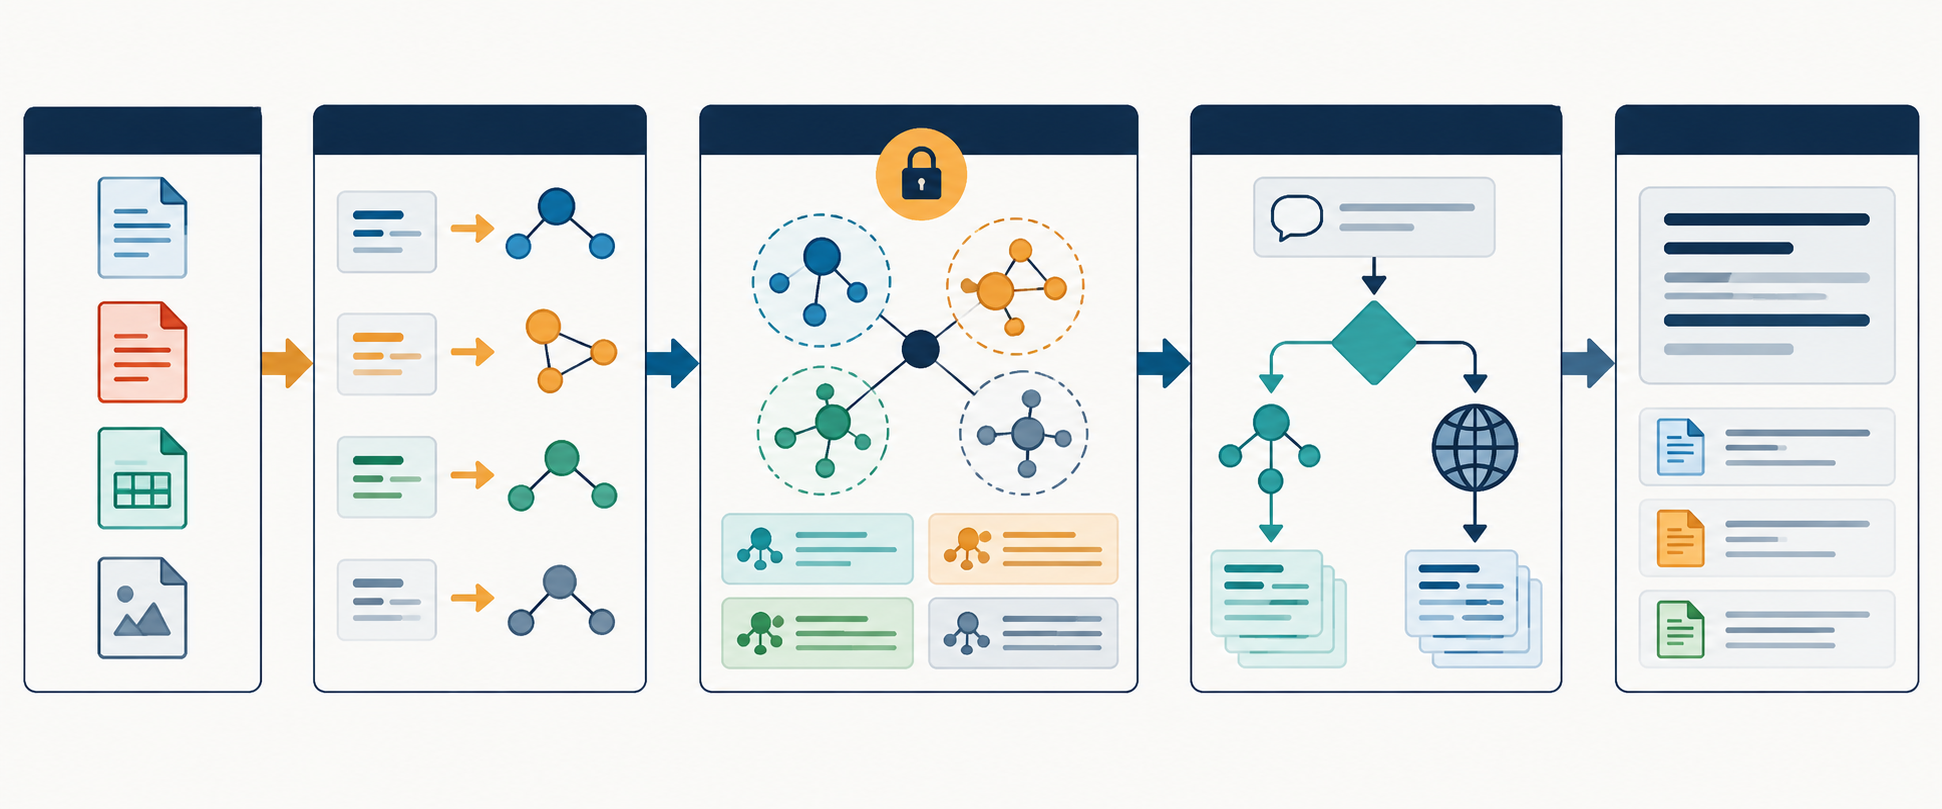
Empieza con documentos versionados y un identificador estable por documento, revisión y chunk. Guarda fuente, fecha de ingesta, idioma, tipo documental y hash de contenido. El chunk sigue siendo recuperable aunque además crees nodos y aristas; no sustituyas la evidencia original por un triple sin contexto.
La extracción produce entidades, relaciones y claims. Una entidad necesita un tipo, nombre canónico, alias y una referencia a los spans donde aparece. Una relación necesita tipo, dirección si la tiene, confianza y los spans que la sostienen. Un claim representa una afirmación verificable, con sujeto, predicado, objeto o valor, fecha de validez y citas a uno o más chunks.
Normaliza entidades con reglas explícitas y revisión de colisiones: dos nombres parecidos pueden ser personas distintas. Conserva tanto la forma observada como el identificador canónico. No fusiones automáticamente entidades con baja confianza; una arista incorrecta puede contaminar búsquedas de varios saltos.
Después calcula comunidades o resúmenes solo sobre subgrafos autorizados y con una versión de extracción identificable. Los resúmenes son derivados y pueden quedar obsoletos; registra sus miembros, fecha, modelo o regla de generación y referencias a las evidencias que los componen.
La actualización incremental debe invalidar lo que corresponda: al cambiar un chunk, recalcula sus entidades, relaciones y claims, revisa las aristas afectadas y vuelve a generar comunidades o resúmenes que dependan de ellas. Un batch nocturno puede ser suficiente al principio; no prometas tiempo real si no puedes propagar borrados y permisos.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisModelo de datos mínimo y procedencia
Un modelo práctico separa Document, Chunk, Entity, Relation, Claim y Community. Document contiene `document_id`, revisión, tenant, clasificación, periodo y estado. Chunk contiene `chunk_id`, texto, offsets y embedding. Entity contiene `entity_id`, tipo, nombre canónico y aliases. Relation conecta entidades, pero apunta a los chunks que la justifican. Claim conserva una afirmación y su evidencia, no solo un score.
Puntos a revisar
Lo que conviene comprobar
Incluye `tenant_id`, `allowed_principals` o una referencia a la política de ACL en cada objeto recuperable. La ACL no debe depender de un texto que el modelo pueda reescribir. Si un documento se comparte entre tenants, modela el ámbito de forma explícita y prueba el caso de revocación.
La procedencia debe poder contestar cuatro preguntas: qué documento originó este dato, qué versión se procesó, qué extractor lo produjo y qué evidencia textual lo respalda. En respuesta, cita chunks reales; un nombre de entidad o un resumen de comunidad sin cita no es una prueba suficiente.
Para una guía adicional sobre este límite, consulta [RAG multi-tenant seguro](/rag-multitenant-filtros-permisos/). La regla es la misma aunque el backend sea un grafo: autorización y procedencia preceden al ranking.
Recuperación segura: ACL antes del grafo
La consulta debe clasificarse antes de recuperar: ¿busca una entidad concreta, una relación o una síntesis global? El runtime obtiene identidad, tenant, región, retención y ACL del contexto autenticado. Esos datos se convierten en un filtro obligatorio para documentos, chunks, entidades, relaciones y comunidades.
No recorras el grafo completo y filtres al final. Una arista entre dos entidades puede revelar indirectamente que existe un documento restringido. Construye una vista o subgrafo autorizado, aplica allowlist de tipos de relación y limita profundidad, número de vecinos, tamaño de comunidad y presupuesto de tiempo.
El siguiente pseudocódigo seguro es ejecutable como contrato conceptual: el adaptador del grafo debe rechazar cualquier llamada sin `tenant_id` y ACL. La búsqueda textual y la navegación gráfica reciben el mismo filtro, y el resultado conserva procedencia.
from dataclasses import dataclass

@dataclass(frozen=True)
class Principal:
    tenant_id: str
    allowed_labels: frozenset[str]

def retrieve_graph(query: str, principal: Principal, graph, text_index):
    if not principal.tenant_id or not principal.allowed_labels:
        raise ValueError("contexto de autorización incompleto")
    acl = {"tenant_id": principal.tenant_id,
           "labels": tuple(sorted(principal.allowed_labels))}
    # El filtro se construye desde la sesión autenticada, nunca desde query.
    seeds = text_index.search(query, filter=acl, limit=12)
    entity_ids = {item.entity_id for item in seeds if item.entity_id}
    allowed = graph.authorized_subgraph(acl, entity_ids, max_hops=2)
    return graph.expand(allowed, relation_allowlist={"depends_on", "owned_by"},
                        max_nodes=80, include_provenance=True)
En un sistema real, `authorized_subgraph` debe hacer cumplir la política en el backend y no ser un simple método de conveniencia. El índice textual, el grafo y el generador de respuesta deben registrar la misma identidad y versión de ACL. Si falta una evidencia o no se puede verificar un permiso, falla cerrado o devuelve una respuesta parcial claramente marcada.
La actualización incremental necesita una política de borrado. Cuando llega una solicitud de eliminación o cambia la ACL, elimina o invalida documentos, chunks, aristas derivadas, comunidades y cachés relacionados. Un grafo que conserva una relación huérfana puede ser una fuga aunque el texto original ya no aparezca.
Controla P50 y P95 de ingestión y consulta, número de nodos visitados, tokens de contexto, coste por respuesta, porcentaje de fallback vectorial y tasa de respuestas sin cita. Guarda trazas suficientes para reconstruir la ruta, pero redacta texto sensible y limita retención.
Evaluación: demostrar que el grafo merece existir
Construye un conjunto de preguntas etiquetado por tipo: factual local, relacional de uno o varios saltos, comparación, síntesis global, pregunta sin respuesta y consulta fuera del tenant. Compara vectorial, híbrido y GraphRAG con la misma política de generación y el mismo presupuesto de contexto.
Métricas mínimas: recall@k de evidencia; exactitud de respuesta y de citas; cobertura de claims; coste por consulta; latencia P50/P95; tasa de errores y fallback; y seguridad, incluyendo cero resultados de otro tenant y cero citas a documentos revocados. Reporta intervalos o tamaños de muestra, no solo una media favorable.
La [guía de evaluación RAG en producción](/evaluacion-rag-produccion-metricas-datasets/) puede servir de base para datasets y regresiones. Añade casos adversariales: prompt injection en un chunk, relaciones contradictorias, entidad homónima, comunidad parcialmente autorizada, borrado reciente y claim con fecha caducada.
Define una regla de salida antes del experimento: por ejemplo, GraphRAG debe mejorar recall relacional y exactitud de citas sin superar un presupuesto de latencia y coste, y no puede degradar seguridad. Si no cruza ese umbral, documenta el resultado y conserva el baseline.
Preguntas frecuentes
¿GraphRAG reemplaza a los embeddings?
No. Puede usar embeddings para encontrar semillas y pasajes, mientras el grafo aporta estructura. En muchos sistemas conviven índice léxico, vectorial y grafo.
¿Necesito Neo4j?
No necesariamente. Neo4j ofrece una implementación GraphRAG para Python, pero la elección depende de consultas, operación, volumen, latencia y habilidades del equipo. Un índice relacional o una tabla de aristas puede bastar para un primer experimento.
¿Cuándo merece la pena un grafo?
Cuando un conjunto medible de preguntas falla por relaciones, saltos o síntesis global, y el beneficio supera ingestión, mantenimiento y latencia.
¿Puedo generar entidades durante cada consulta?
Para producción, normalmente conviene extraer y versionar durante ingestión. La extracción online añade latencia y dificulta la reproducibilidad; úsala solo como experimento controlado.
¿Cómo respondo si dos fuentes contradicen un claim?
Conserva ambos claims con fechas y procedencia, aplica una política de vigencia o presenta la contradicción. No elijas silenciosamente por score del modelo.
¿Un subgrafo autorizado garantiza seguridad?
Es una barrera importante, pero prueba también el índice textual, cachés, resúmenes, logs, exportaciones y el modelo. La seguridad debe mantenerse en cada ruta de datos.
Cómo probar GraphRAG sin sobrediseñar la arquitectura
- Crear el baseline. Implementa RAG vectorial o híbrido con filtros de tenant, citas y métricas de recall, coste y latencia.
- Etiquetar consultas. Separa preguntas locales, relacionales, globales, sin respuesta y fuera de ámbito; conserva ejemplos reales anonimizados.
- Definir el esquema. Versiona Document, Chunk, Entity, Relation, Claim y Community con procedencia, tenant, ACL, fechas y estado de borrado.
- Extraer una muestra. Procesa un subconjunto, anota entidades y relaciones, mide precisión y recall, y revisa colisiones antes de ampliar el corpus.
- Aplicar autorización. Construye el subgrafo desde la identidad autenticada, filtra antes de expandir, limita profundidad y devuelve procedencia en cada evidencia.
- Comparar estrategias. Ejecuta vectorial, híbrido, local y global con el mismo dataset y presupuesto; registra calidad, coste, P95, fallbacks y violaciones de seguridad.
- Decidir y operar. Conserva el baseline si no hay mejora clara; si la hay, versiona extractores, prueba borrados y cambios de ACL, monitoriza deriva y programa una revisión periódica.
Conclusión: estructura solo cuando paga su alquiler
GraphRAG es una herramienta para hacer explícitas relaciones y síntesis que un ranking de chunks no captura bien. Su valor no está en dibujar más nodos, sino en producir respuestas mejores y auditables para una clase concreta de preguntas.
La decisión profesional empieza por un baseline, un dataset y una política de seguridad. Añade extracción, comunidades y recorridos gradualmente; conserva el texto y sus citas; mide actualización, coste y latencia; y acepta que la respuesta correcta puede ser no introducir un grafo. La arquitectura más sencilla que gana la evaluación suele ser la más sostenible.
Fuentes y referencias
También te puede interesar
Búsqueda híbrida RAG: BM25, vectores y rerankingEvaluación RAG en producción: métricas y datasetsRAG multi-tenant seguro: filtros y permisosEmbeddings para RAG: modelos y dimensionesReescritura de consultas RAG: mejora el recallRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis